🎉NOVOCapSolver para agentes de IA-Integrações de MCP, ferramentas de agente e SDK
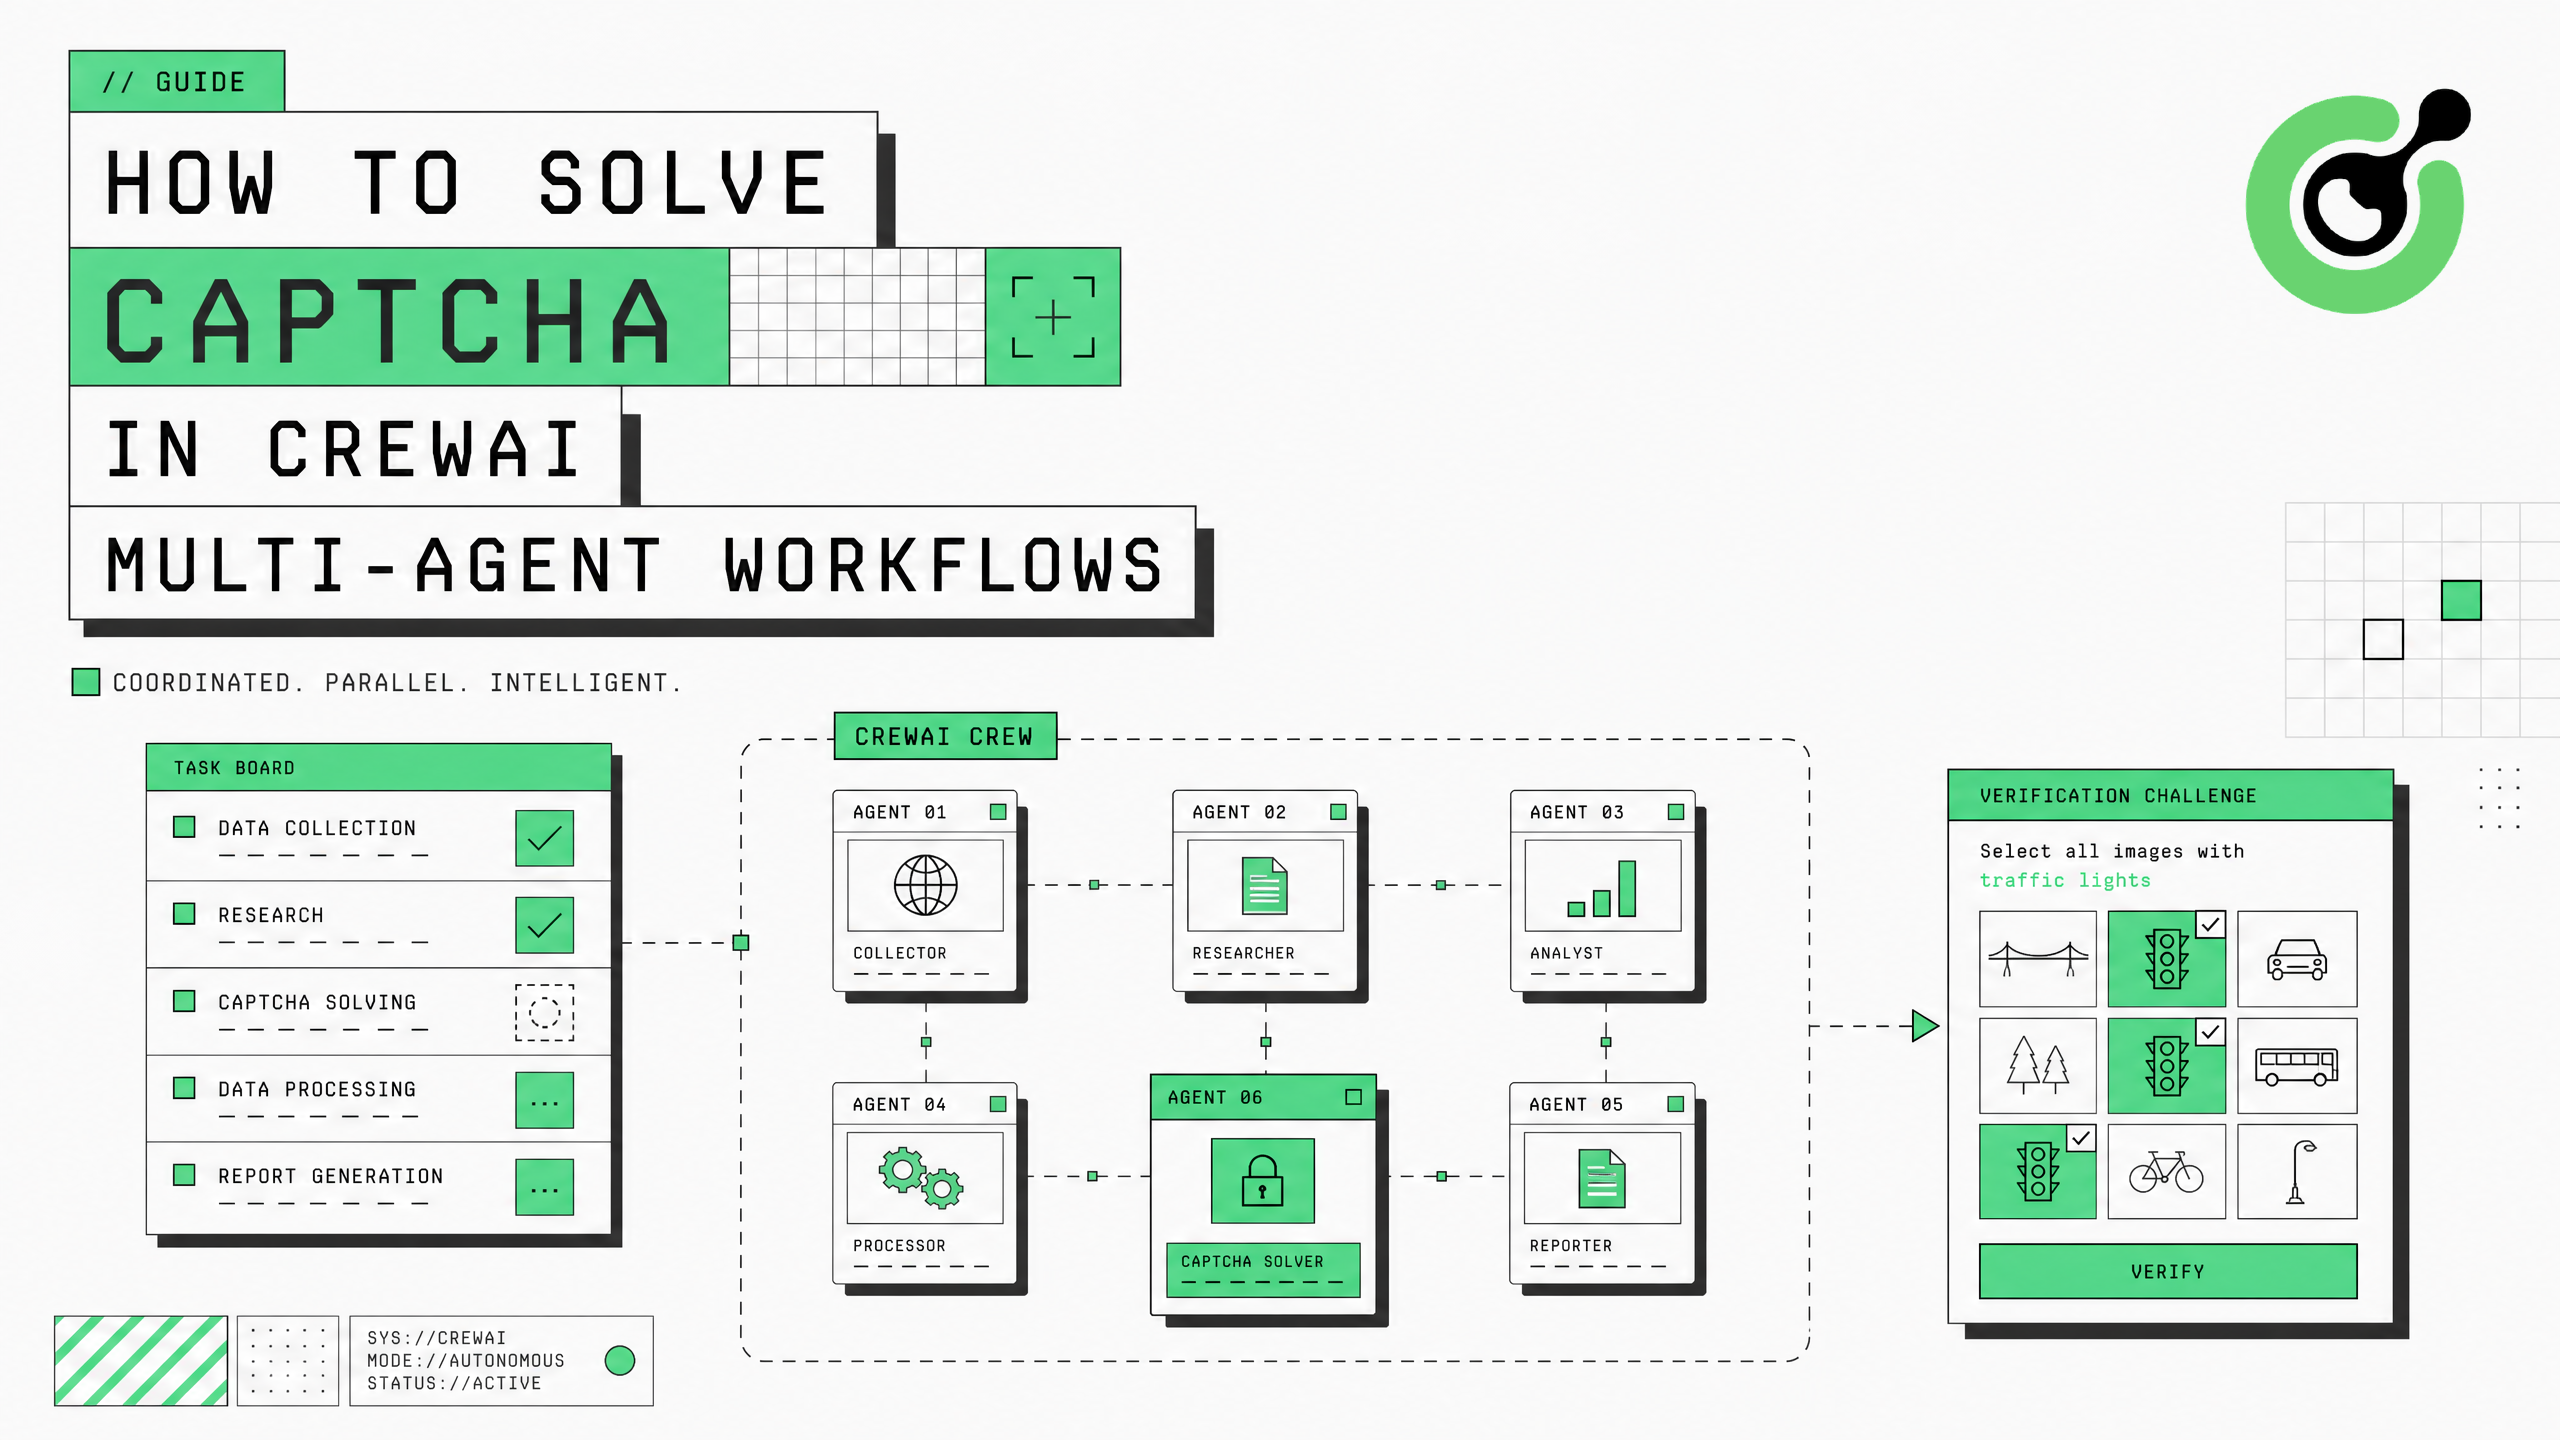
Guia completo para integrar a resolução de CAPTCHA em fluxos de trabalho multi-agentes do CrewAI usando o CapSolver, com exemplos de código para reCAPTCHA e Cloudflare Turnstile.
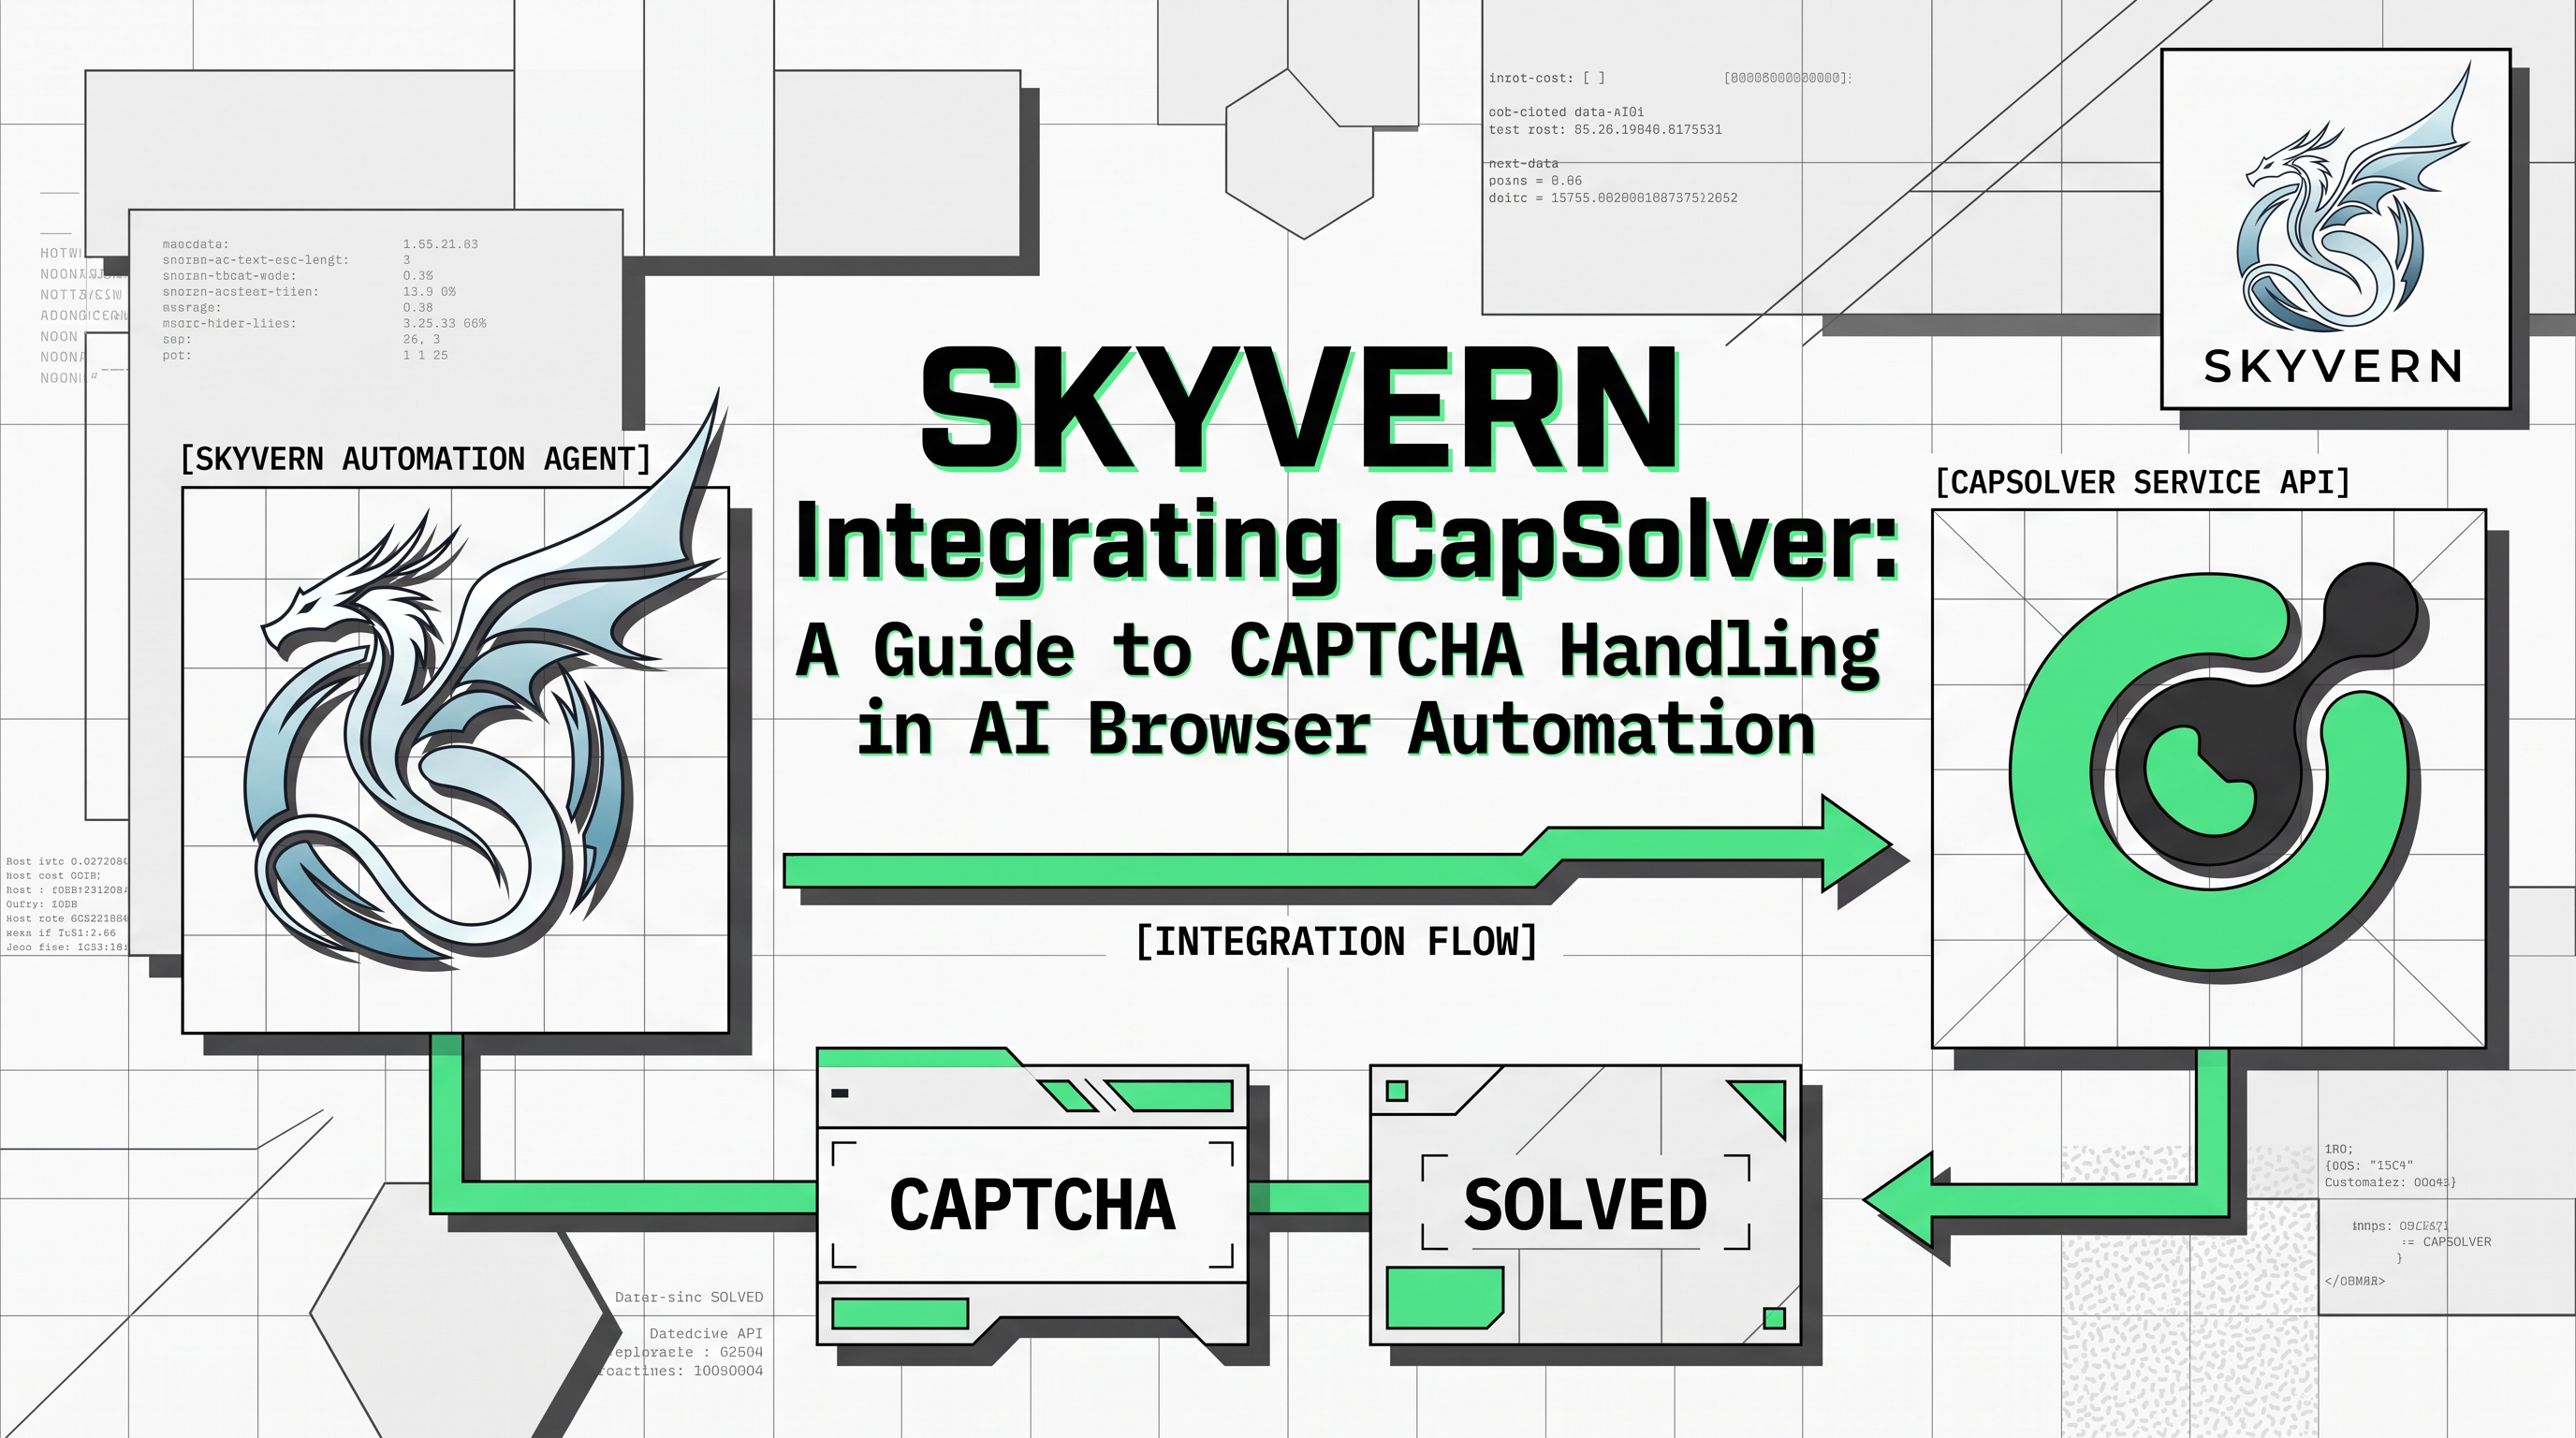
Descubra como gerenciar de forma eficaz e burlar desafios CAPTCHA na automação de navegadores de IA. Este guia fornece passos práticos para soluções de automação web robustas e escalonáveis.
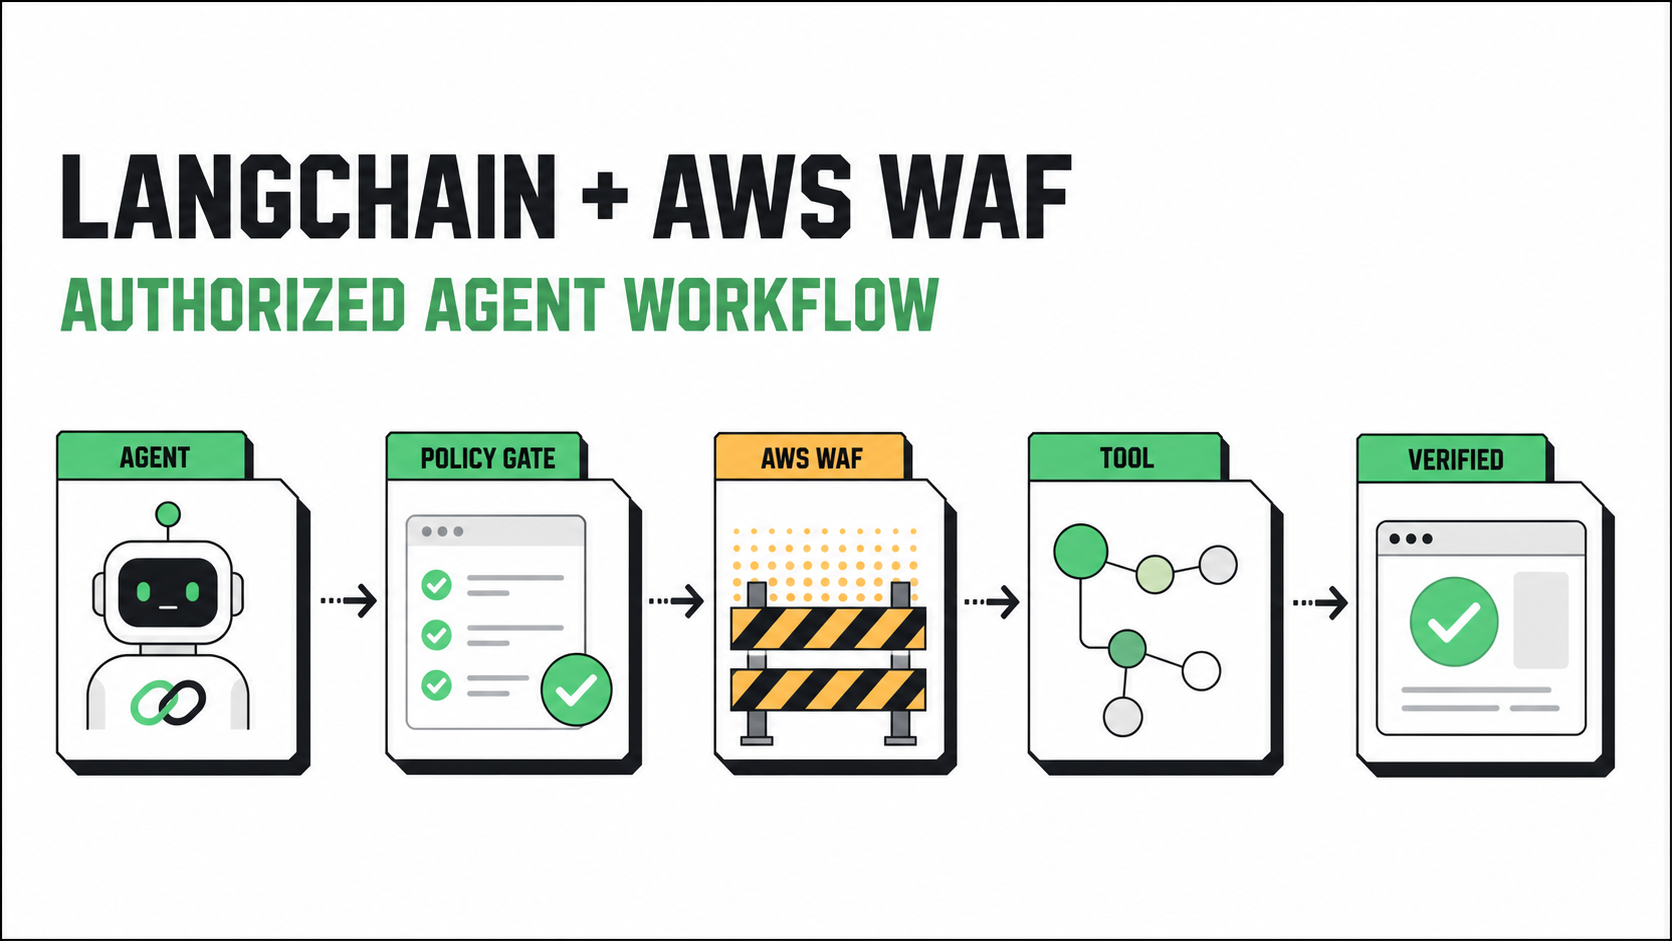
Construa um fluxo de trabalho autorizado da AWS WAF LangChain com ferramentas CapSolver, detecção de respostas, portas de política, gerenciamento de sessão, tentativas de repetição e verificação.
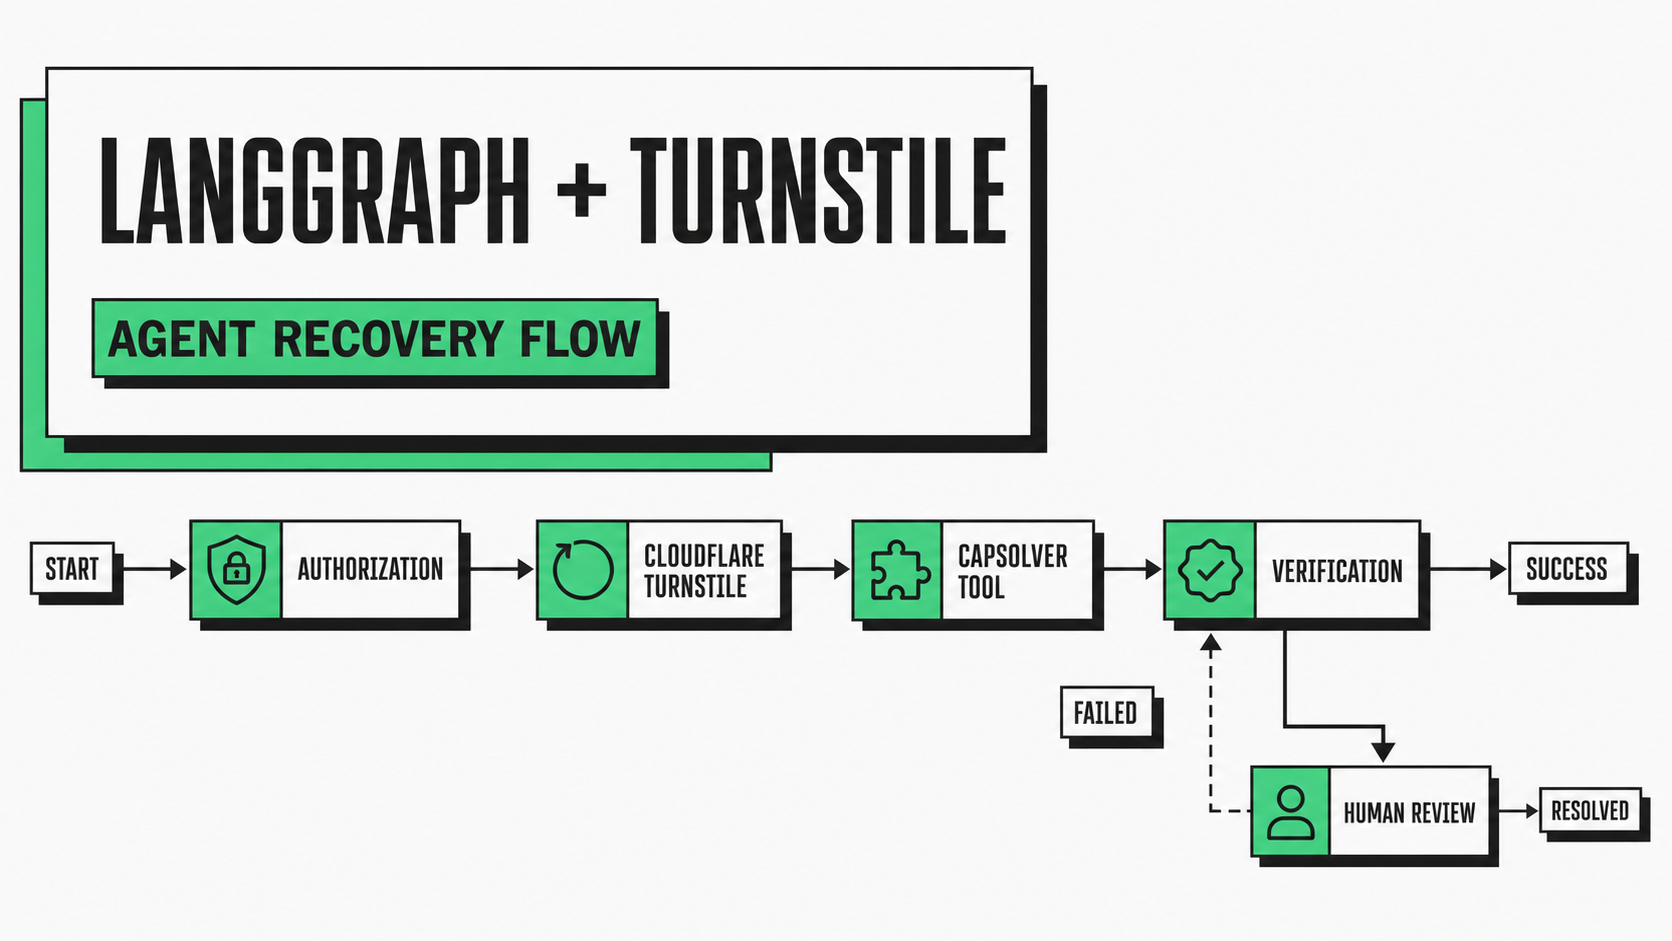
Construa um fluxo de trabalho solucionador do Cloudflare Turnstile com o CapSolver, gerenciamento de sessão do Playwright, portões de política, retries, verificação e revisão.
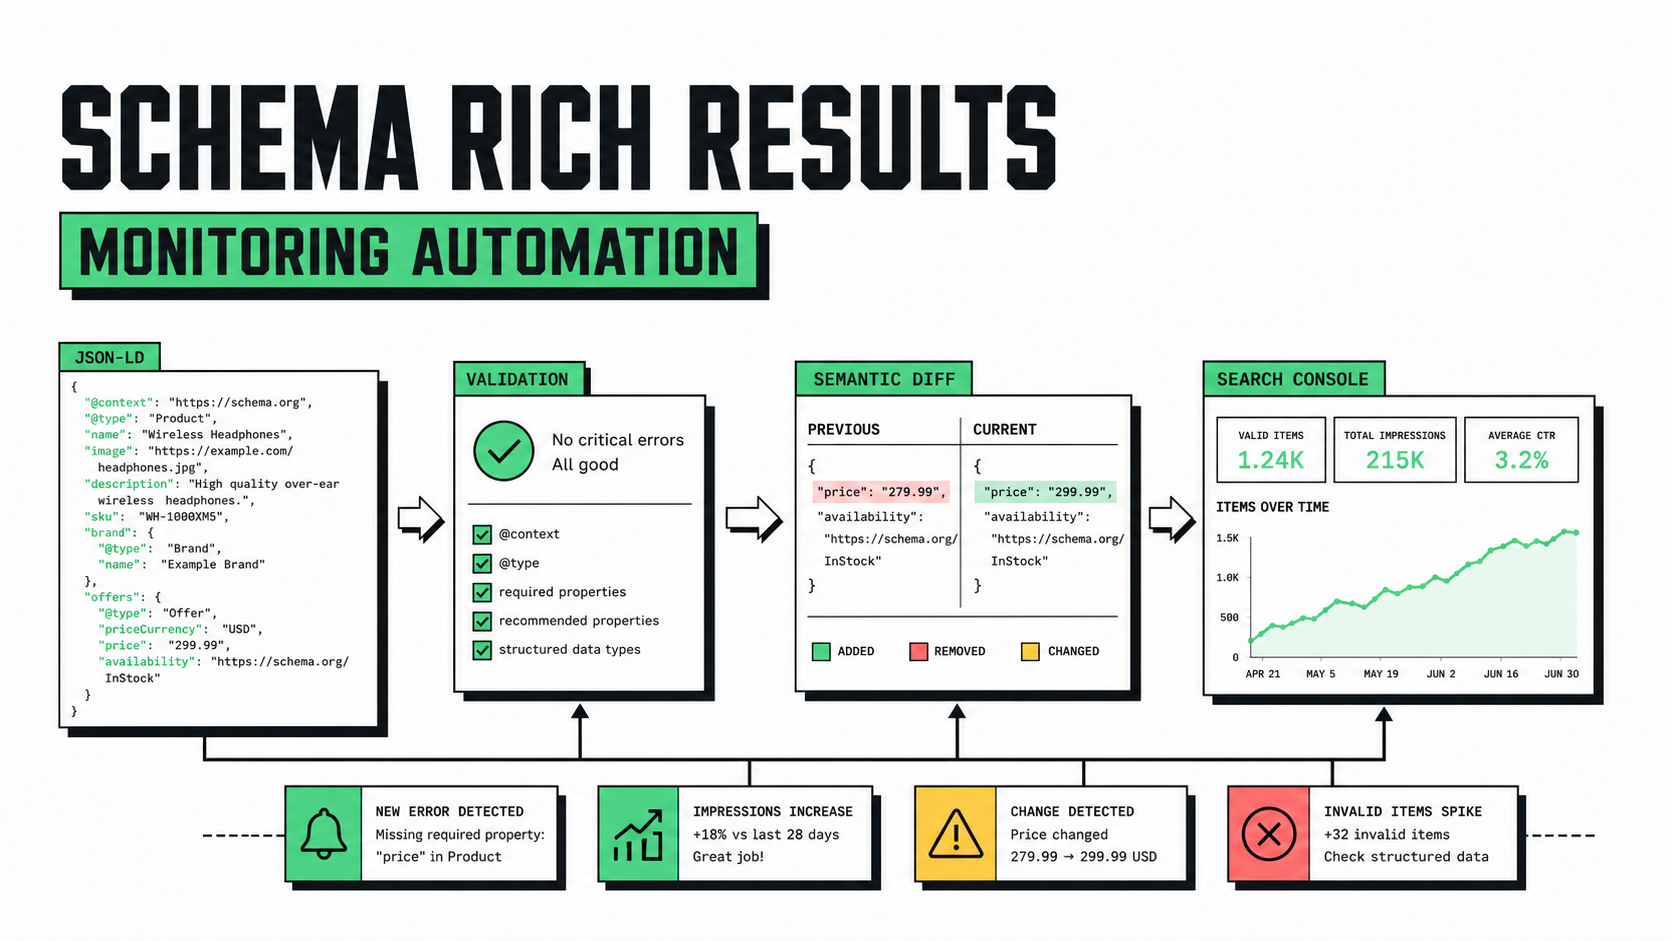
Aprenda como automatizar o monitoramento de resultados ricos do schema com extração JSON-LD, bases semânticas, validação, dados do Google Search Console e alertas úteis.

Construa um monitoramento de regressão de SEO técnico com bases versionadas, diferenças semânticas, alertas verificados e uma etapa opcional de recuperação CAPTCHA autorizada.
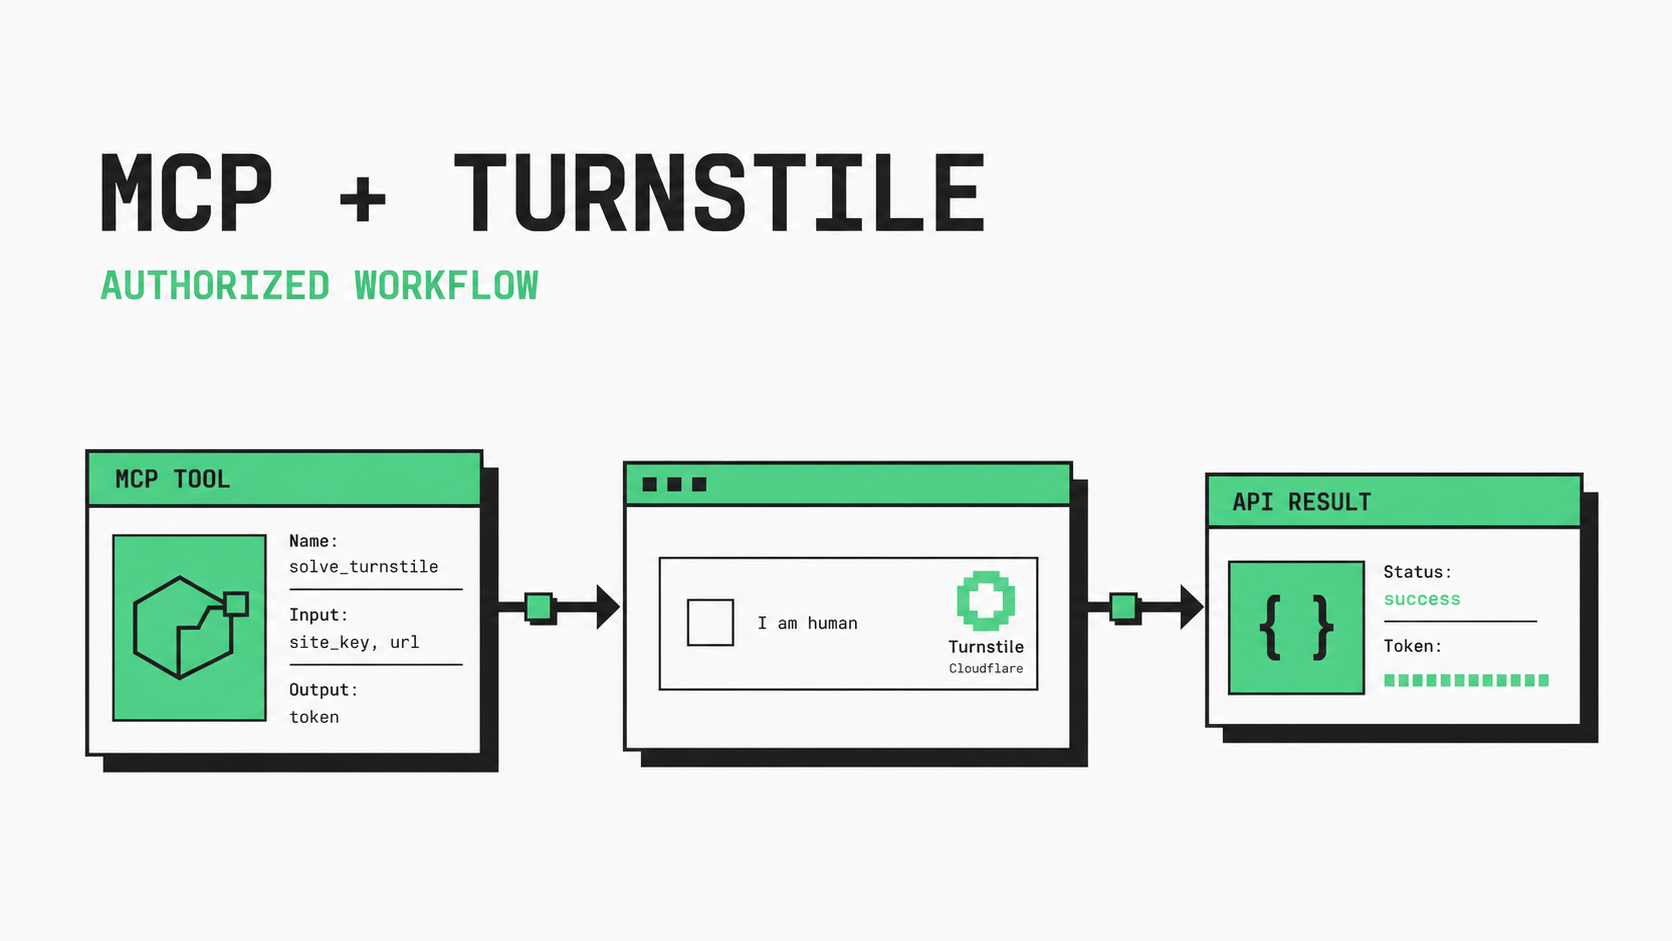
Construa um fluxo de trabalho MCP Cloudflare Turnstile com gate de política, retries limitados, logs redatados, verificações de sessão e validação de resultados.

Crie uma ferramenta de agente solucionador de CAPTCHA com o CapSolver, esquemas de ferramentas seguras, orçamentos de tentativas e verificação para reCAPTCHA e Cloudflare Turnstile.
Construa um solucionador de Cloudflare Turnstile para o Scrapy com transferência de sessão do CapSolver, middleware de download, orçamento de tentativas e verificação de conteúdo.
Siga este tutorial de resolução de reCAPTCHA para criar um cenário HTTP do CapSolver com createTask, getTaskResult, ramificações de tentativa novamente e verificação.

Construa um fluxo de trabalho de resolução de CAPTCHA para o Claude Computer com guardas do CapSolver, IDs de evidências visuais, verificações de políticas e verificação confiável.
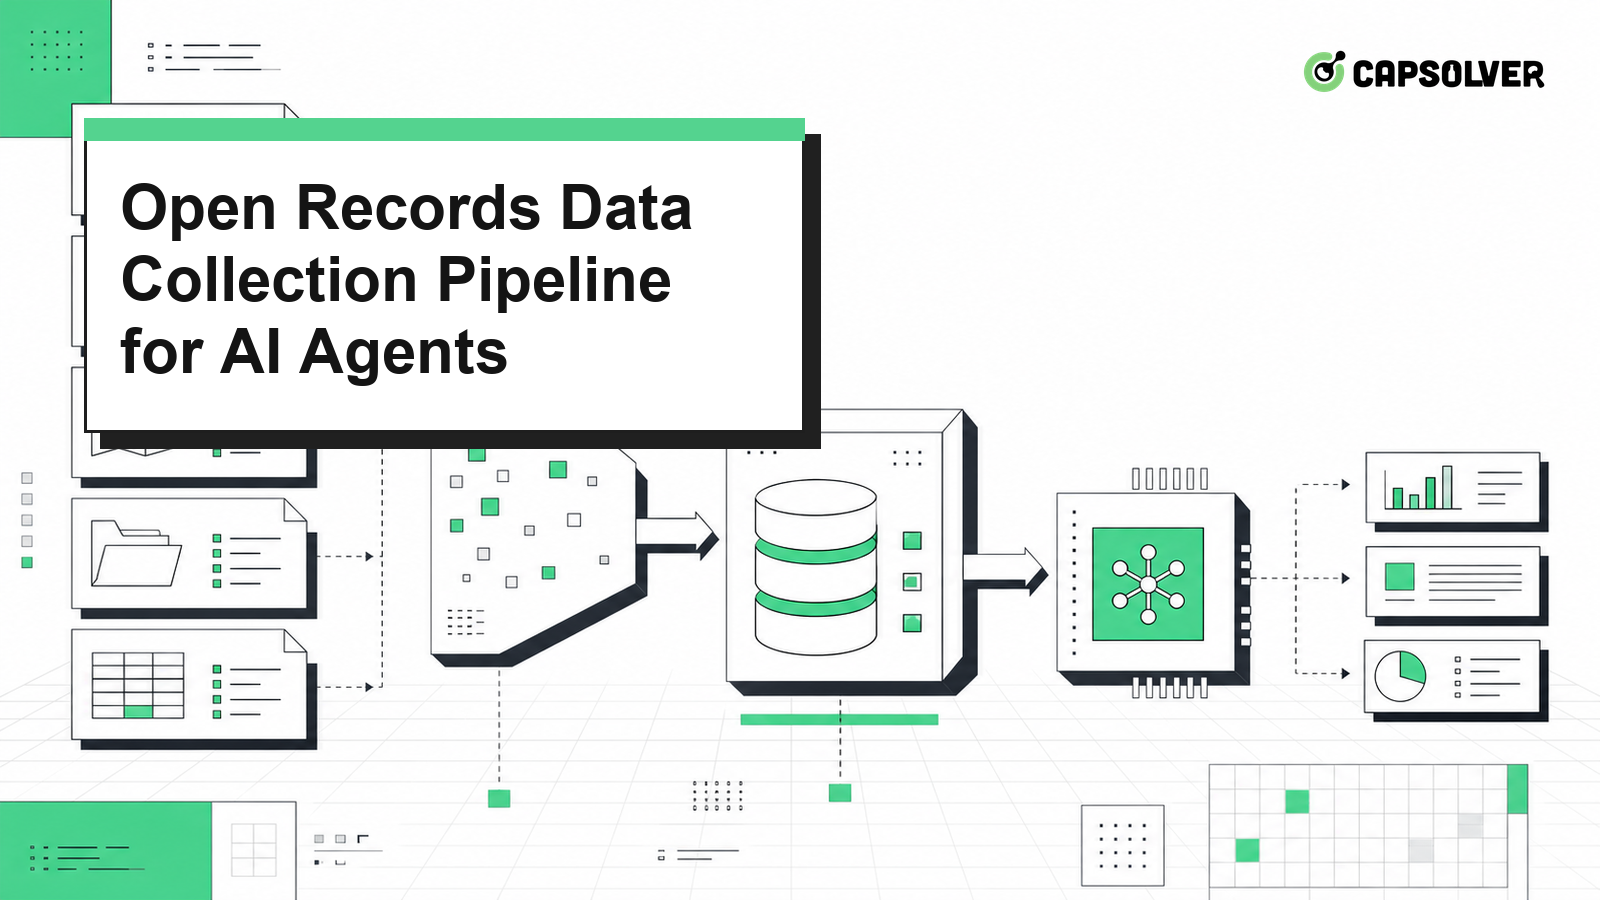
Uma pipeline de coleta de dados de registros abertos para agentes de IA deve separar a recuperação de fontes públicas do raciocínio do modelo. A primeira menção visível ao CapSolver aponta para o CapSolver porque desafios do navegador podem aparecer durante fluxos de trabalho de portais públicos, e essas verificações devem ser tratadas com código documentado. O padrão mais seguro é uma pipeline de três etapas: aprovar a fonte, coletar apenas campos públicos permitidos, depois alimentar registros normalizados para o agente. Isso mantém o modelo focado em um