🎉NUEVOCapSolver para agentes de IA-Integraciones de MCP, herramientas de agente y SDK
Guía completa para integrar la resolución de CAPTCHA en flujos de trabajo multiagente de CrewAI usando CapSolver, con ejemplos de código para reCAPTCHA y Cloudflare Turnstile.
Descubre cómo gestionar de manera efectiva y evadir los desafíos CAPTCHA en la automatización de navegadores de inteligencia artificial. Este guía proporciona pasos prácticos para soluciones de automatización web robustas y escalables.
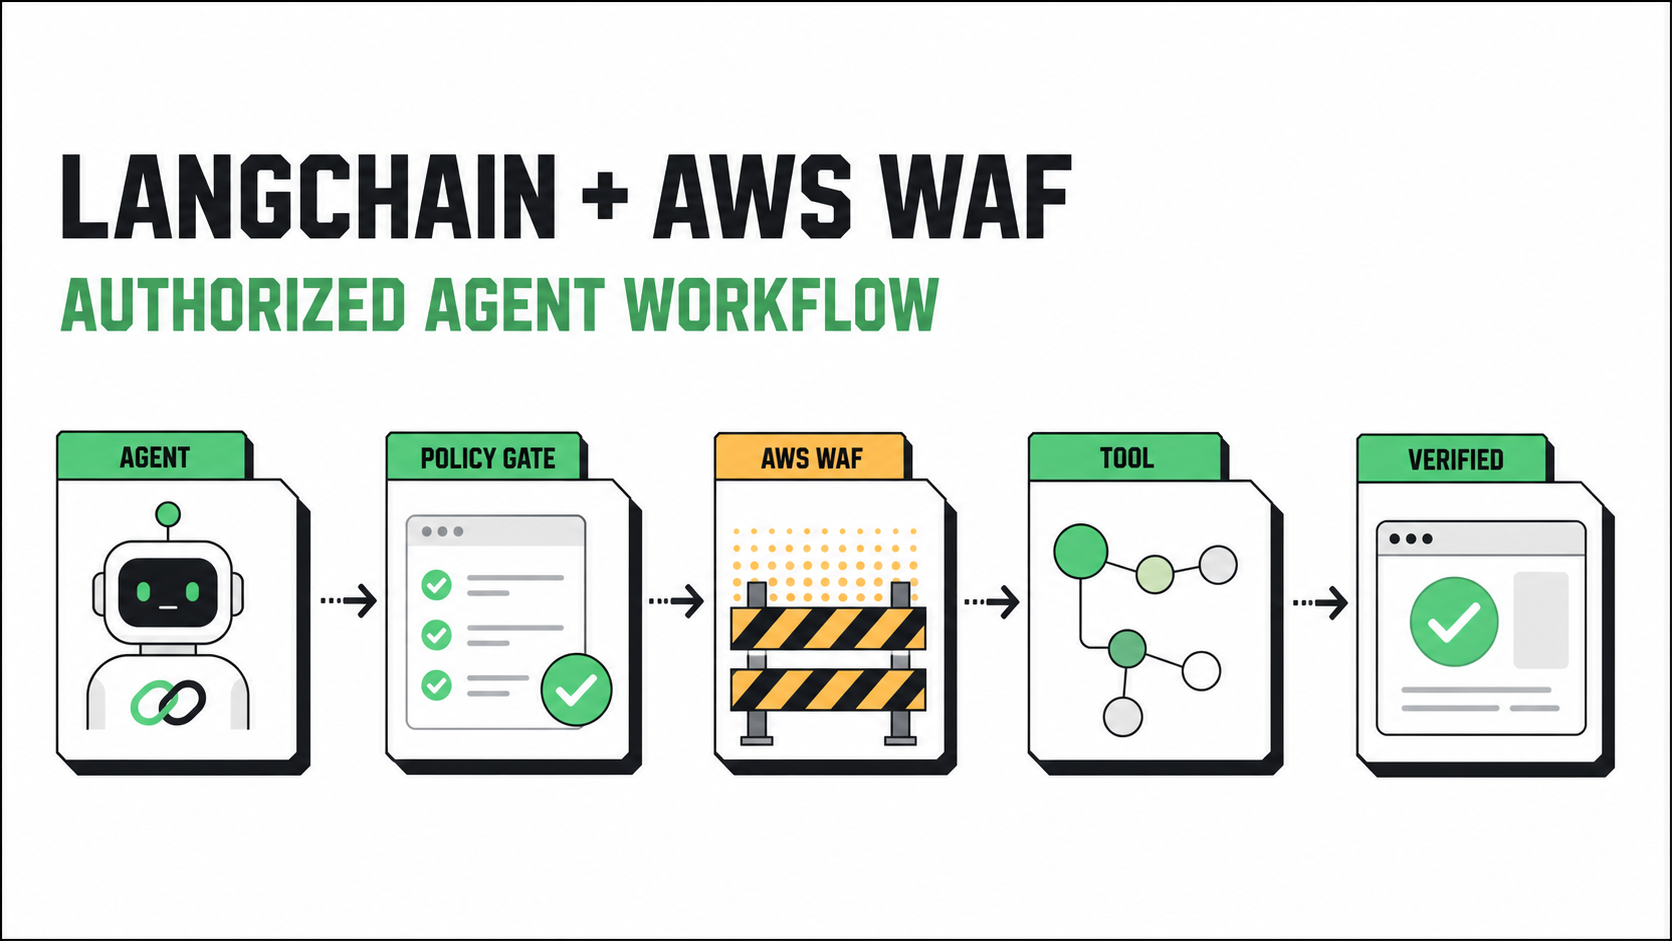
Construya un flujo de trabajo de AWS WAF autorizado con herramientas CapSolver, detección de respuestas, puertas de política, manejo de sesiones, reintentos y verificación.
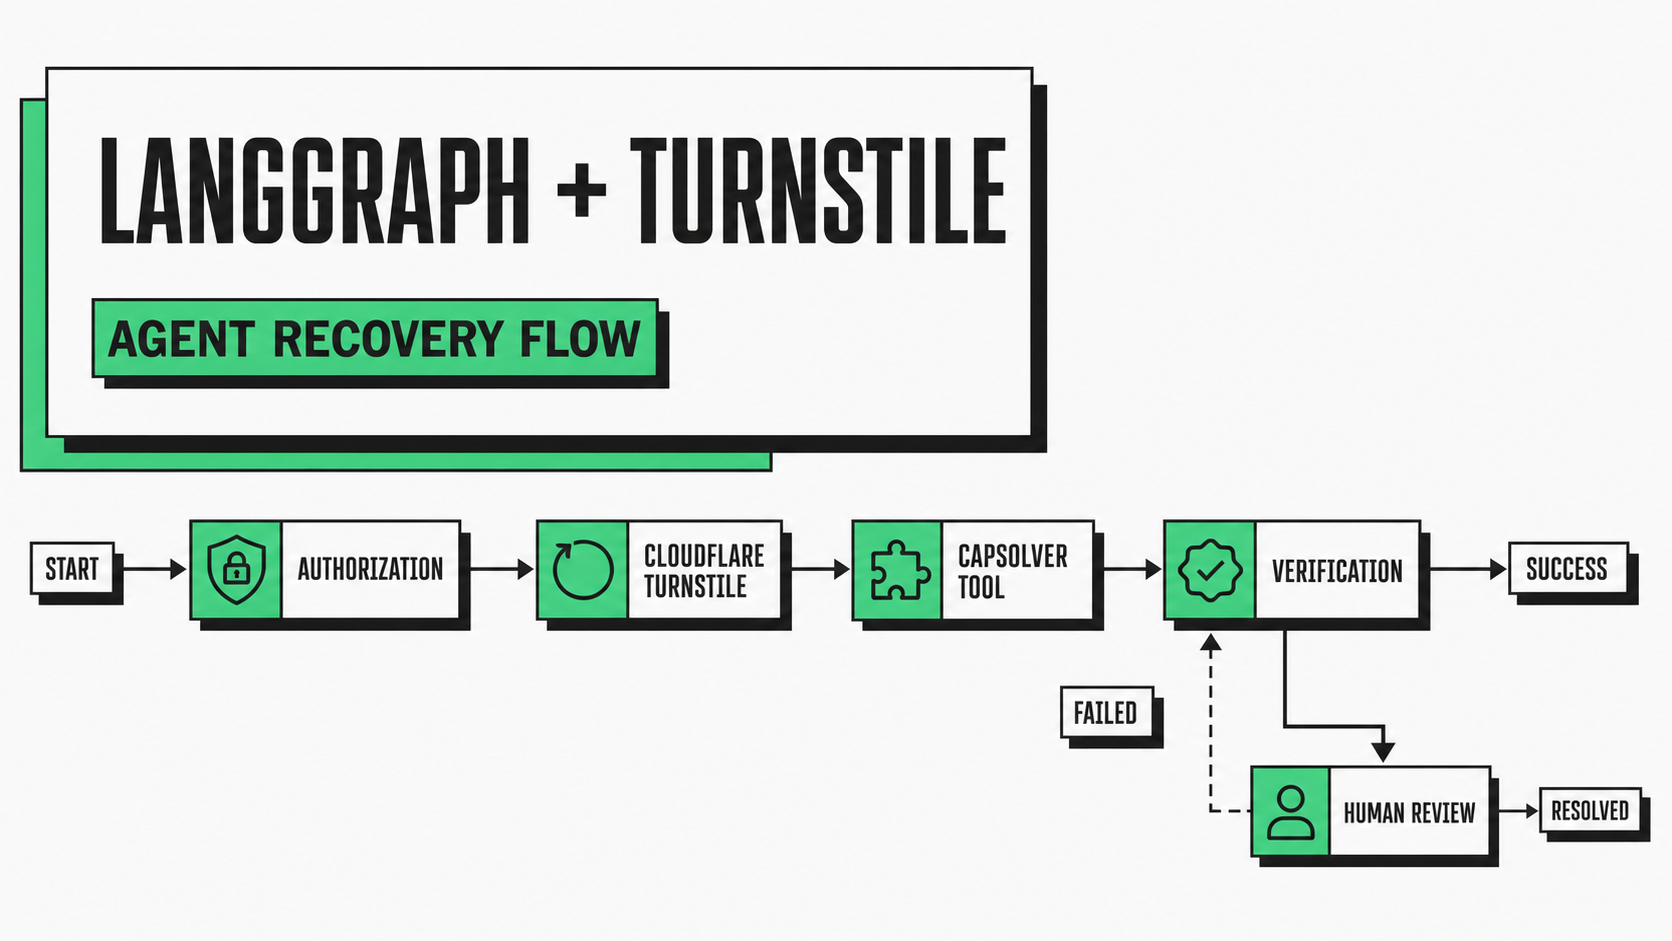
Construye un flujo de trabajo de solucionador de Cloudflare Turnstile de LangGraph con CapSolver, manejo de sesiones de Playwright, puertas de política, reintentos, verificación y revisión.
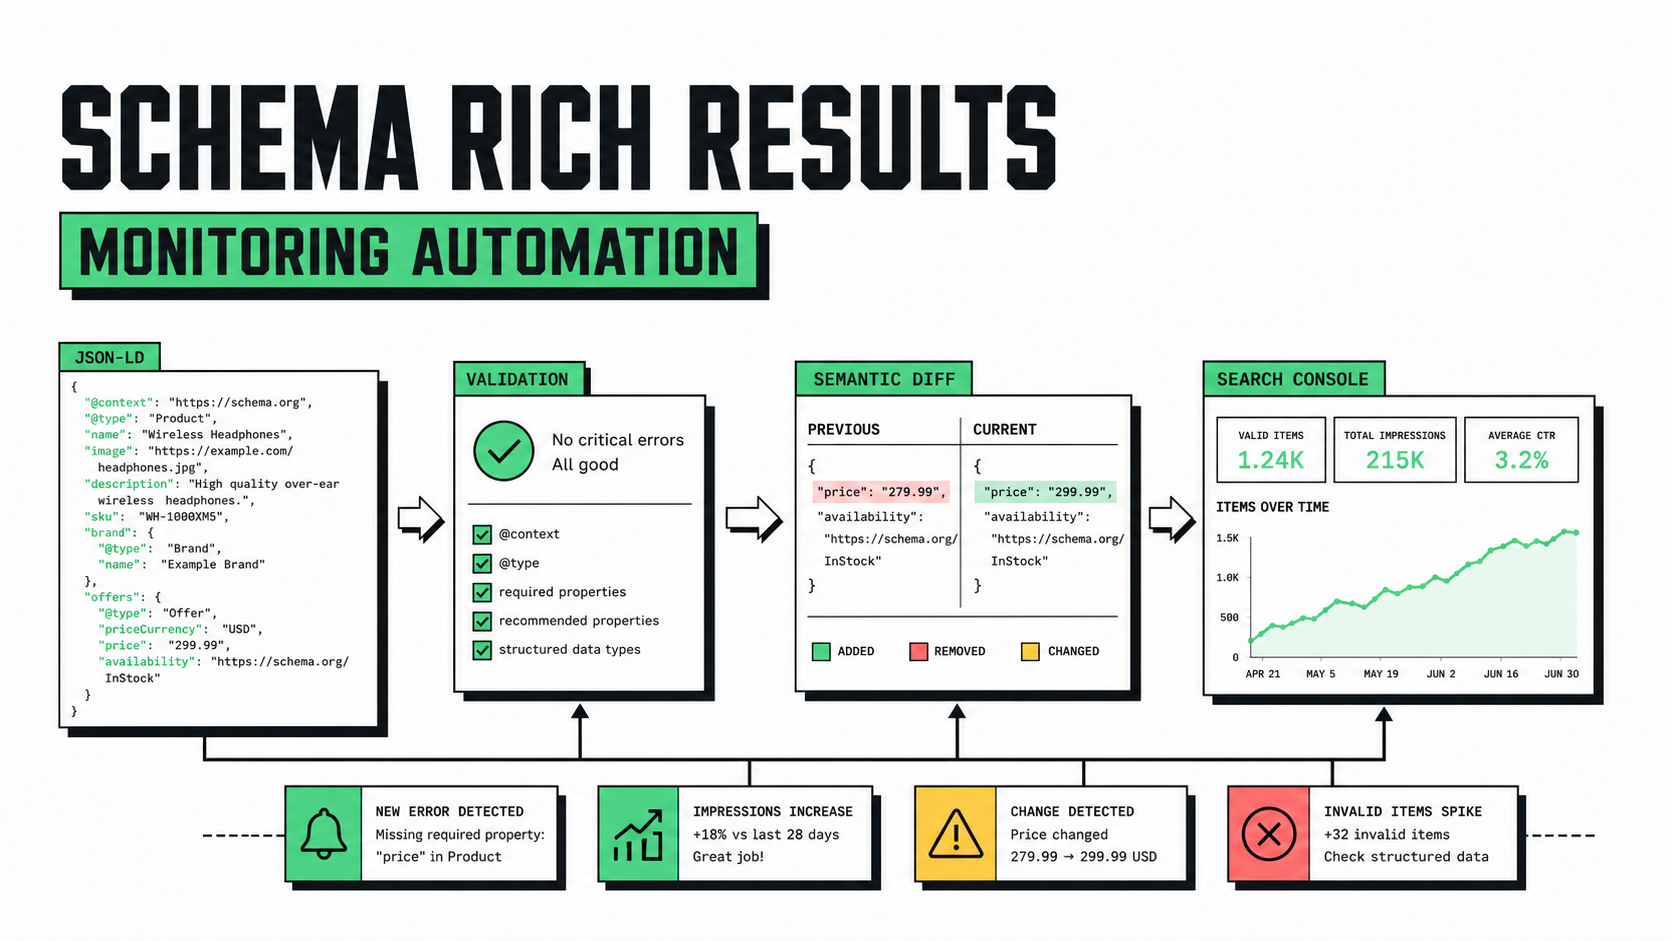
Aprende a automatizar el monitoreo de resultados ricos de esquema con la extracción de JSON-LD, líneas base semánticas, validación, datos de Search Console y alertas útiles.

Construir un monitoreo de regresión de SEO técnico con líneas base versionadas, diferencias semánticas, alertas verificadas y un paso opcional de recuperación CAPTCHA autorizado.
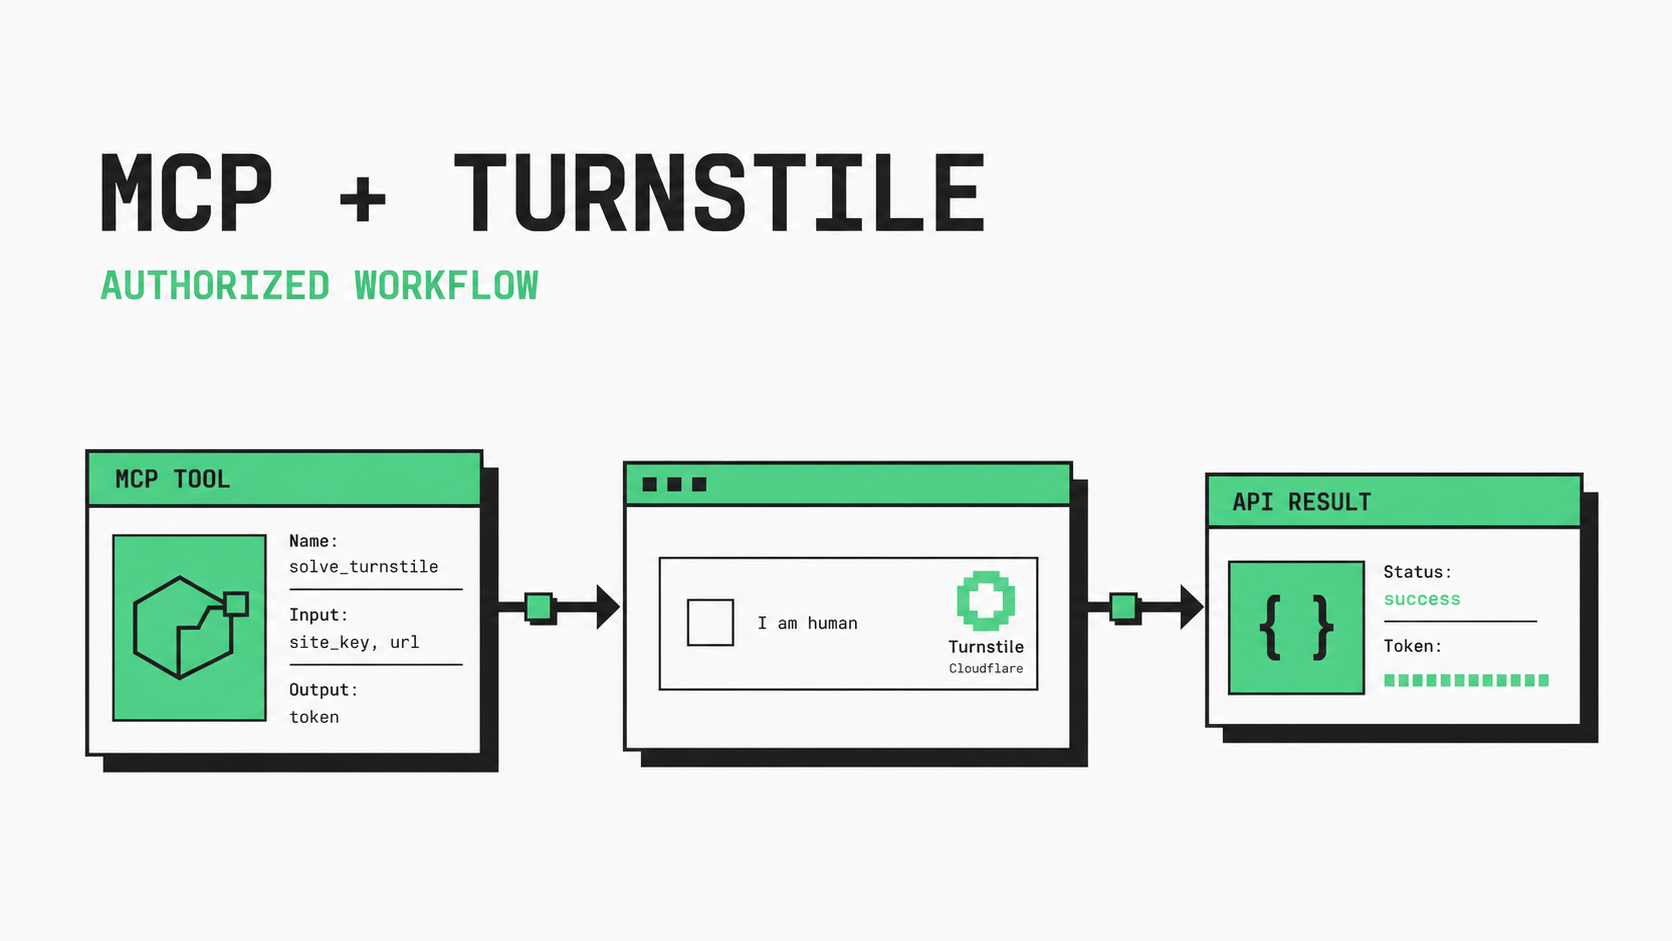
Construya un flujo de trabajo de MCP de Cloudflare Turnstile con CapSolver, reintentos limitados, registros con datos eliminados, verificaciones de sesión y validación de resultados.

Crear una herramienta de agente solucionadora de CAPTCHA de LangChain con CapSolver, esquemas seguros, límites de reintentos y verificación para reCAPTCHA y Cloudflare Turnstile.
Construye un solucionador de Cloudflare Turnstile con transferencia de sesión de CapSolver, middleware de descarga, límites de reintentos y verificación de contenido.
Sigue este tutorial de Make para resolver reCAPTCHA para crear un escenario HTTP de CapSolver con createTask, getTaskResult, ramas de reintentos y verificación.

Construye un flujo de trabajo para resolver CAPTCHA con dispositivos de seguridad de CapSolver, identificaciones de evidencia visual, verificaciones de políticas y verificación confiable.
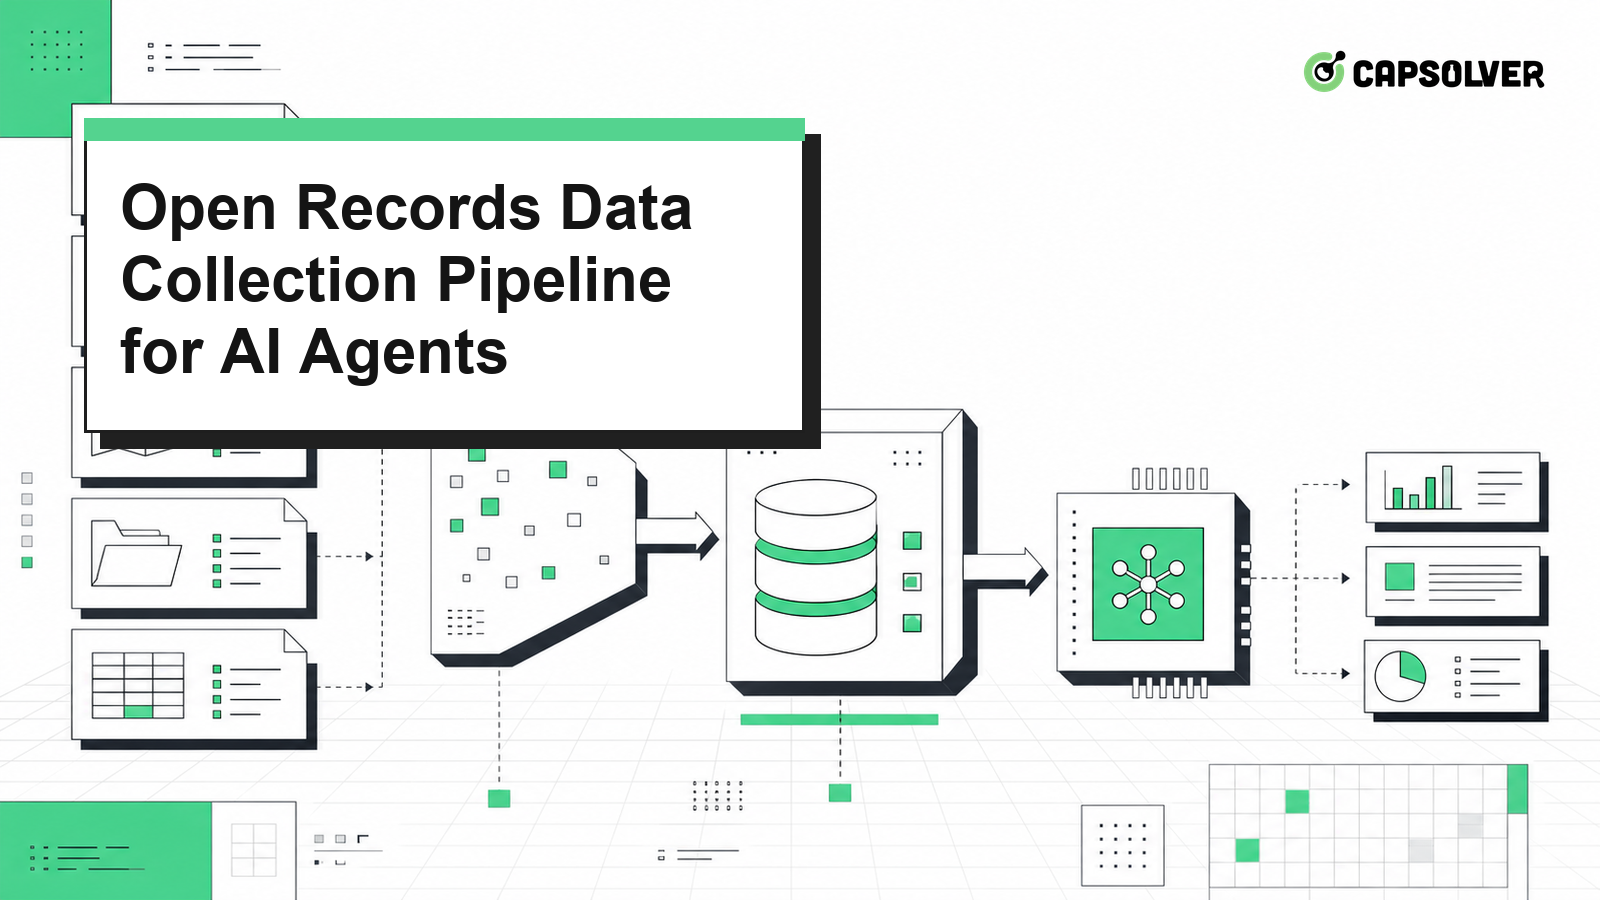
Una pipeline de recolección de datos de registros abiertos para agentes de IA debe separar la recuperación de fuentes públicas del razonamiento del modelo. La primera mención visible de CapSolver apunta a CapSolver porque pueden aparecer desafíos de navegador durante los flujos de trabajo de portales públicos, y esos controles deben manejarse con código documentado. El patrón más seguro es una pipeline de tres etapas: aprobar la fuente, recopilar solo los campos públicos permitidos, luego alimentar registros normalizados al agente. Esto mantiene al modelo enfocado en un