क्योंकि वेब स्क्रैपिंग ग्राहक भावना विश्लेषण को कैसे सक्षम बनाता है?
उत्तर
वेब स्क्रैपिंग ग्राहक भावना विश्लेषण की अनुमति देता है क्योंकि यह वेबसाइटों से उपयोगकर्ता-जनित सामग्री जैसे समीक्षाएं, टिप्पणियां और रेटिंग के बड़े आयतन को स्वचालित रूप से संग्रहीत करता है। इस डेटा को एनएलपी मॉडल के माध्यम से प्रसंस्कृत किया जाता है ताकि भावनाएं, राय और प्रवृत्तियां निर्धारित की जा सकें, जो व्यवसायों को ग्राहक अपेक्षाओं को समझने और उत्पादों, सेवाओं और प्रचार रणनीतियों में सुधार करने में मदद करता है।
विस्तृत स्पष्टीकरण
ग्राहक भावना विश्लेषण वाक्यांश डेटा से अर्थपूर्ण अंतर्दृष्टि निकालने पर निर्भर करता है, और वेब स्क्रैपिंग इस डेटा के संग्रह के लिए एक महत्वपूर्ण भूमिका निभाता है। हाथ से फीडबैक एकत्र करने के बजाय, स्क्रैपिंग टूल स्वचालित रूप से ई-कॉमर्स प्लेटफॉर्म, फोरम, सोशल मीडिया और समीक्षा साइटों से सामग्री प्राप्त करते हैं। इससे संगठनों को विविध, वास्तविक समय के विचारों तक पहुंच मिलती है।
जब डेटा एकत्र कर लिया जाता है, तो इसे सबसे पहले साफ किया जाता है और संरचित किया जाता है जिसके बाद इसे प्राकृतिक भाषा प्रक्रमण (एनएलपी) एल्गोरिथ्म द्वारा प्रसंस्कृत किया जाता है। इन मॉडलों द्वारा भावना को सकारात्मक, नकारात्मक या उदासीन श्रेणियों में वर्गीकृत किया जाता है और वे भावना की तीव्रता या विषय-विशिष्ट भावना की पहचान भी कर सकते हैं। उन्नत मशीन लर्निंग मॉडल वास्तविकता, विरोधाभास और क्षेत्र-विशिष्ट भाषा की समझ के माध्यम से अक्सर सटीकता में सुधार करते हैं।
लगातार डेटा संग्रह और स्वचालित विश्लेषण के संयोजन से व्यवसाय भावना प्रवृत्तियों की निगरानी कर सकते हैं, उभरती समस्याओं की पहचान कर सकते हैं और प्रतिक्रियात्मक रूप से प्रतिक्रिया कर सकते हैं। इससे बिखरे ऑनलाइन विचारों को संरचित अंतर्दृष्टि में बदल दिया जाता है जो डेटा-आधारित निर्णय लेने और प्रतिस्पर्धी विश्लेषण में सहायता करता है।
समाधान / विधियां
- स्वचालित डेटा निकालने के पाइपलाइन : विवरण फ्रेमवर्क और क्रॉलर का उपयोग करके समीक्षाएं, रेटिंग और सोशल मीडिया टिप्पणियां स्वचालित रूप से संग्रहीत करें। इससे वास्तविक समय में भावना निगरानी के लिए ताजा डेटा के प्रवाह की गारंटी मिलती है।
- आर्टिफिशियल इंटेलिजेंस-संचालित भावना विश्लेषण मॉडल : नियम-आधारित प्रणाली या ट्रांसफॉर्मर-आधारित मॉडल जैसे एनएलपी तकनीकों के उपयोग से भावना वर्गीकरण और भाव, इच्छा या विशेषता-स्तरीय प्रतिक्रिया जैसे अंतर्दृष्टि निकालें।
- कैपचा और सुरक्षा चुनौतियों का प्रबंधन : बहुत सारे वेबसाइट स्क्रैपिंग गतिविधियों को ब्लॉक करने के लिए सुरक्षा प्रबंधन प्रणाली लगाते हैं। CapSolver जैसे स्वचालित कैपचा हल करने वाले सेवाओं का उपयोग करके कैपचा चुनौतियों को बिना किसी बाधा के दक्षता और विश्वसनीयता से हल करें।
शीर्ष अभ्यास / सलाह
- शोध निर्बाधता और भावना में भेद के कारण भ्रम को रोकने के लिए उच्च गुणवत्ता वाले डेटा स्रोतों पर ध्यान केंद्रित करें।
- मॉडल की सटीकता में सुधार के लिए डेटा साफ करें और द्विगुणित डेटा को हटाएं।
- स्थैतिक छवि पर भरोसा करने के बजाय भावना के समय के साथ निगरानी करें।
- भावना के डेटा के साथ व्यापार मापदंडों (जैसे बिक्री या ग्राहक ह्रास) को जोड़कर गहरी अंतर्दृष्टि प्राप्त करें।
👉 संबंधित:
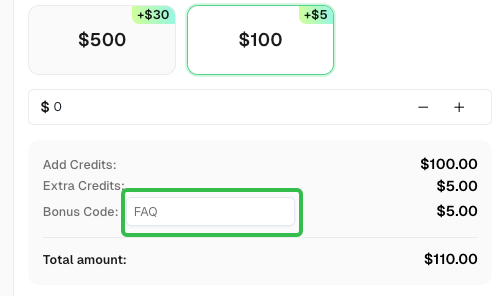
CapSolver पर पंजीकरण करते समय
FAQकोड का उपयोग करें ताकि आपके भुगतान में 5% अतिरिक्त बोनस मिले।
CapSolver FAQ — capsolver.com